SheepComb について
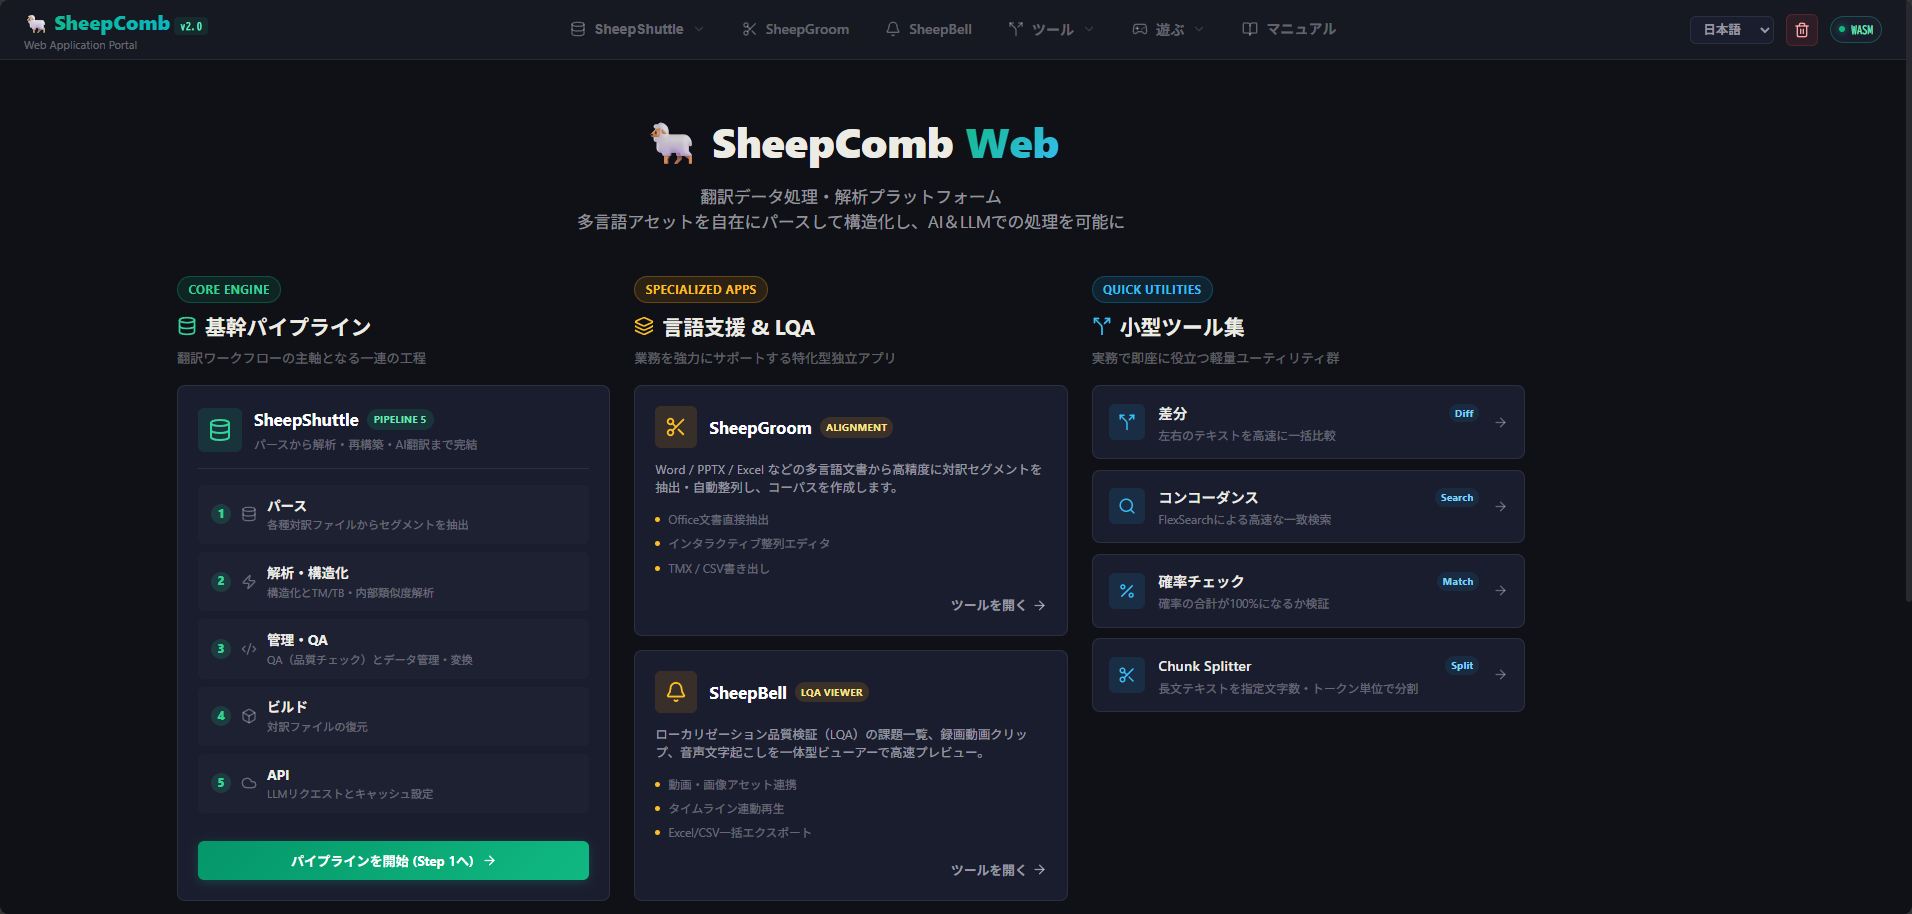
SheepComb は ファイル変換、対訳作成、LQA 支援、テキスト処理 など、翻訳や言語処理業務でよく使うプログラムを、GUI としてまとめた Web アプリです。
データ処理について
ほとんどの機能はブラウザで完結しており、SheepBobbinと連携する場合を除いて、すべてオフラインでも使用可能です。
SheepShuttle
翻訳をしていると、対訳データを使うことがよくあります。 CAT ツールはその最たるもの。
原文と訳文を横に並べ、一つずつ順番に訳していく……
でも、思ったことはありませんか?
- これ、Excel にエクスポートしたい
- 訳文だけ縦に一気にコピーしたい
- 結局どことどこが似ているのか、ツールで見るまで分からないのは不便
- AI と連携できるといっても、ツール側で準備された機械翻訳しかない
- XLIFF ファイルと TMX ファイルと TBX ファイルがバラバラになってしまう
- などなど……
こういった悩みに応える形で拡張してきたのが、SheepShuttle です。
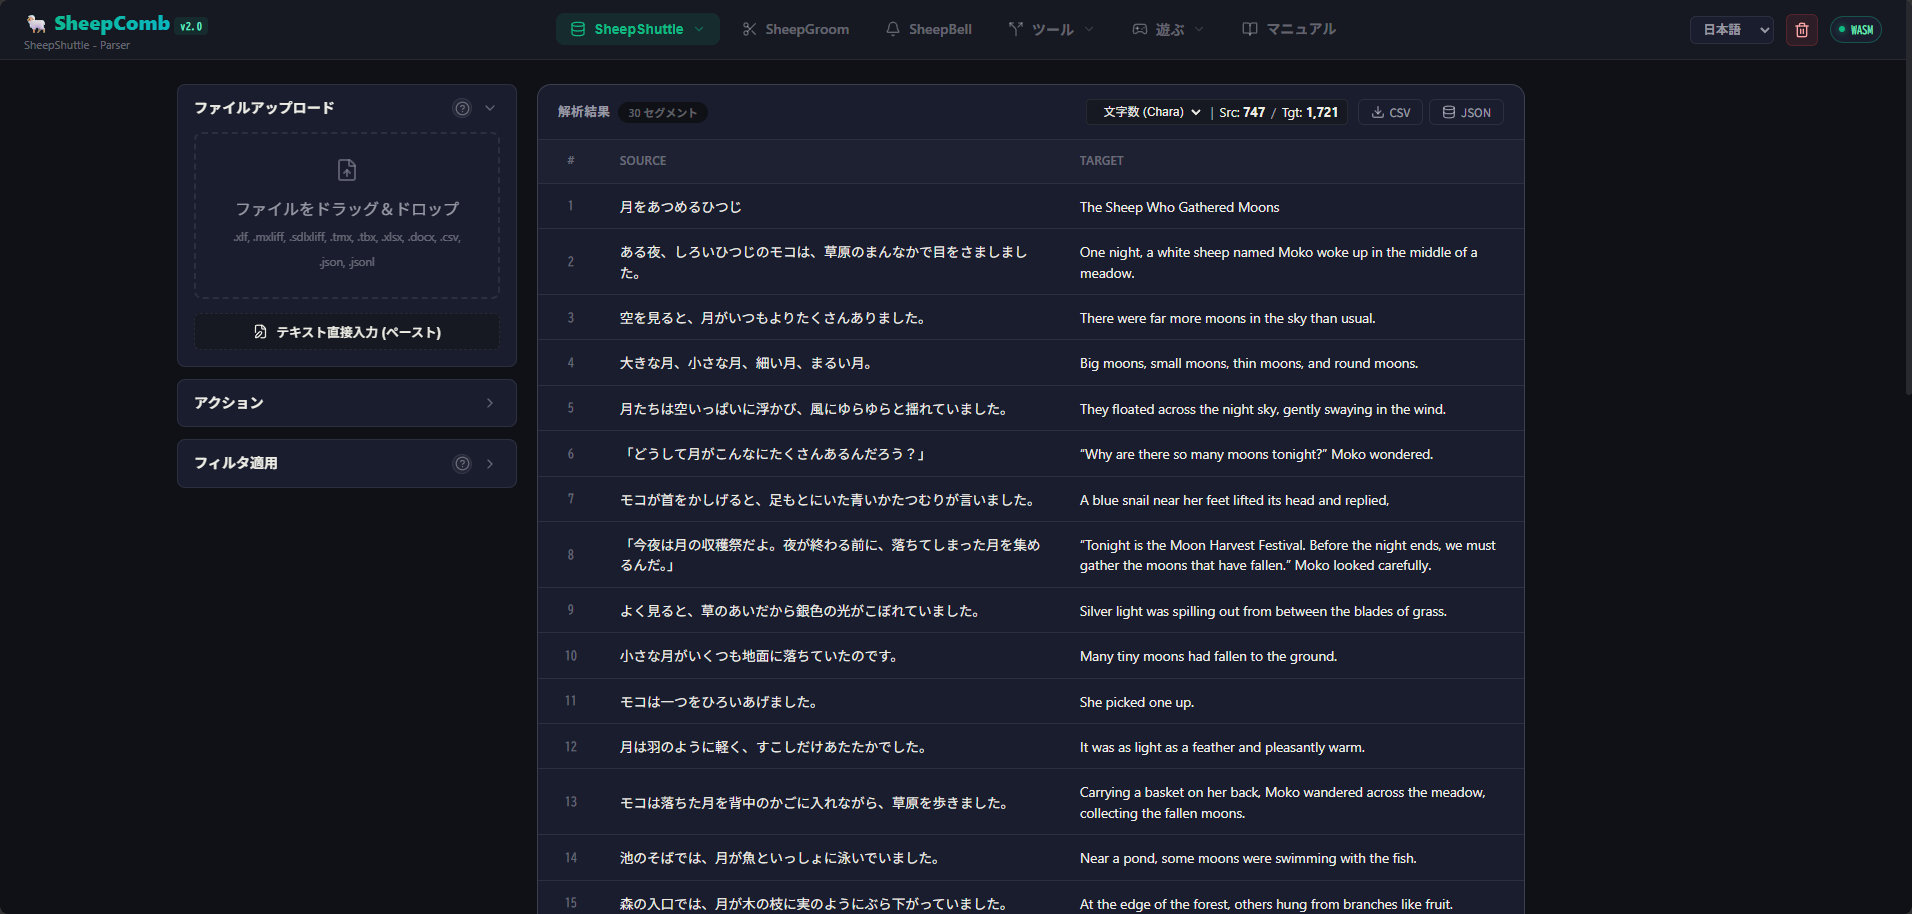
SheepShuttle は翻訳の開始を支援するツールではなく、すでに存在する翻訳資産を活用するためのツールです。 そのため、対訳ファイルや翻訳メモリ、用語集の存在を前提としています。 SheepShuttle には下記のような機能が備わっており、上記の悩みにも簡単に答えられます。
- XML(XLIFF 等)や CSV 等の翻訳データを取り出し、カウント・構造化(TM/TB の適用確認)
- 翻訳メモリ(TM)や用語集(TB)と照らし合わせ、一致する箇所を検出
- タグの破損や数字・用語集との不一致を検出(QA)
- データを AI が扱いやすいサイズに「小分け(チャンク化)」したり、別形式で保存
- 小分けにしたデータと指示(プロンプト)を AI へ送り、一括で翻訳やチェック
- AI での処理に適した構造化 + 追加情報の注入で精度アップ。ローカル/クラウド LLM に対応
複雑になりがちな翻訳データを、分かりやすい形で再構成し、必要に応じてもう一度ツール用のファイルに戻す。 織機の杼(ひ)のように、整然と行ったり来たりできるのがSheepShuttleのイメージです。
SheepShuttle で対訳ファイルを処理したい場合は、こちらをご覧ください。
SheepGroom
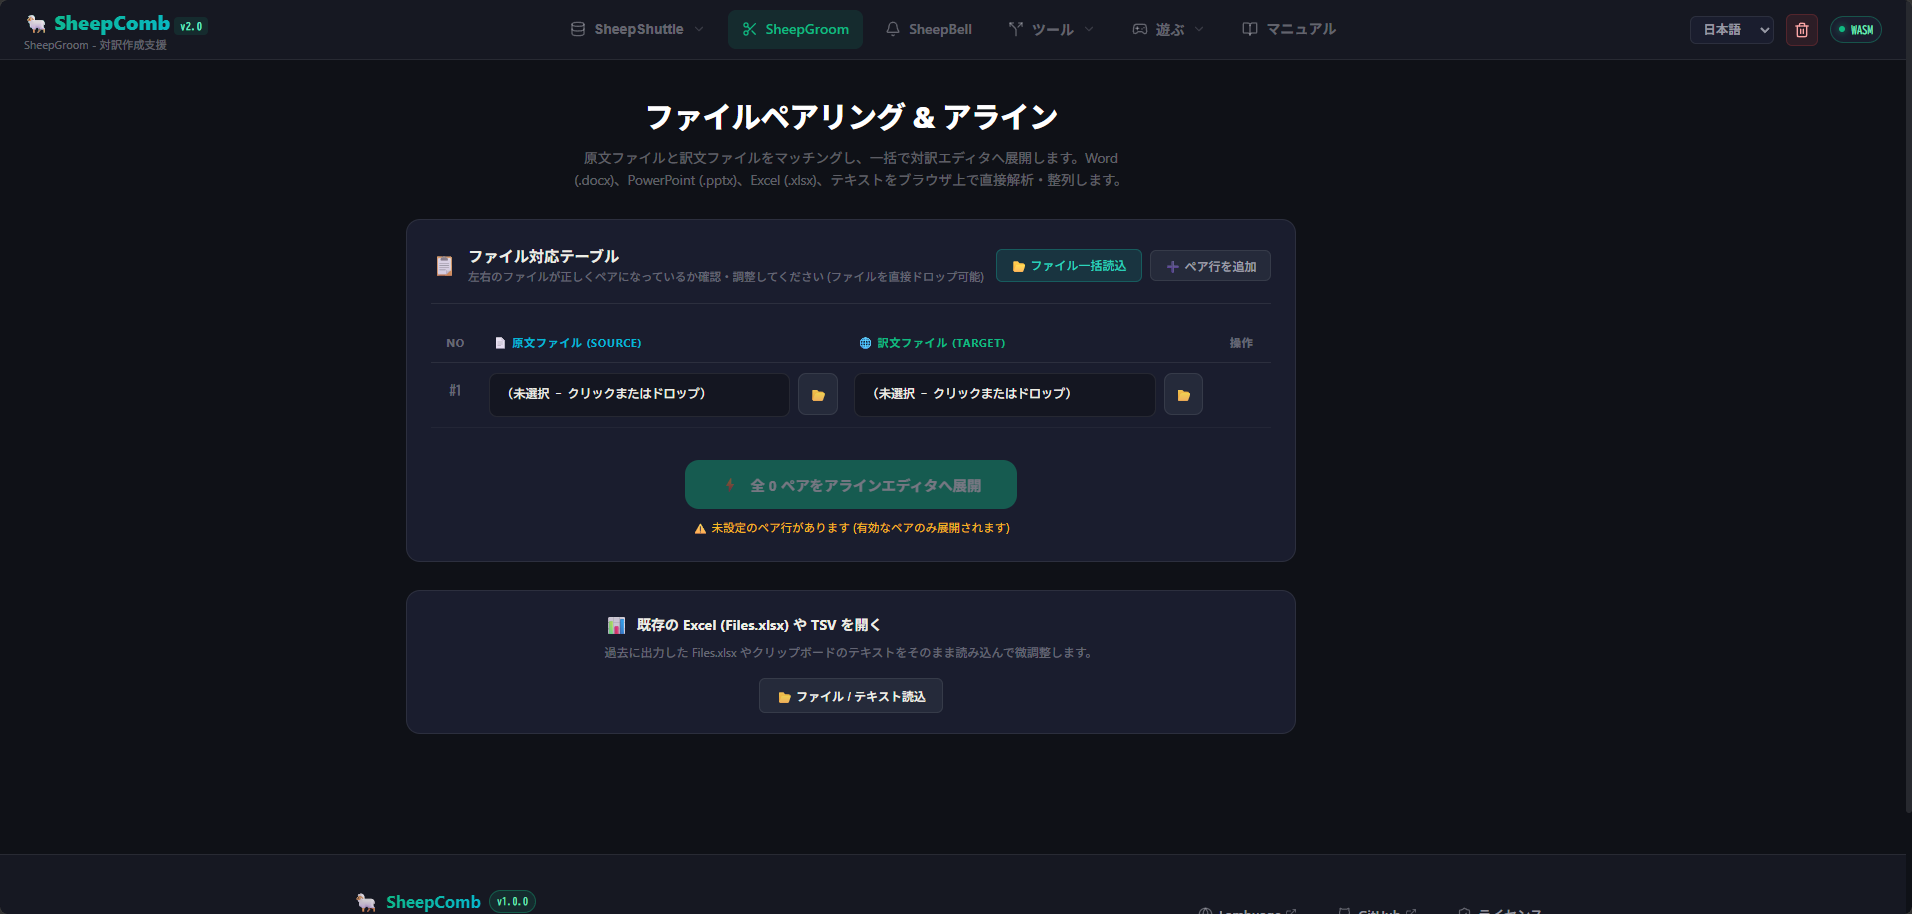
Word / Excel / PowerPoint で翻訳した場合、原文ファイルと翻訳ファイルが別になっています。 この場合、上記の SheepShuttle では活用が難しくなります。 また、翻訳以外の角度からも、DTP や Web 制作などで使う際は、原文と訳文がペアになっていた方がオペレーターが楽だという側面もあります。
そこで登場するのが アラインツール。 翻訳前後の文書を比較し、原文と訳文の対応関係を作成するために使われます。
既存の CAT ツールにもアライン機能は備わっていますが、長年使っていて、使いづらさを感じたこともあります。
どうして「段落」「シート」「スライド」「ノート」といった情報を捨てて、テキストだけで照合するのだろう、と。
また、翻訳メモリとして使うなら確かに文単位が便利ですが、もっとざっくりと高速でつくる仕組みがあってもいいんじゃないか、と。
こういった思いから生まれたのが SheepGroom です。 SheepGroom は、まず「人が見て分かる単位」で対応関係を見つけ、必要に応じて細かく調整することを重視しています。 段落・シート・スライドといった粗い粒度での照合から入ることで、
- ある程度の塊の対訳がほしい場合はそのまま
- 文レベルでの細かい対訳がほしいなら手動で調整 を自由に選択できます。
さらに、調整時も「何番目の段落」「何スライド目」「同じテキストボックス内」といった情報を残すことで、作業者が原文・訳文を見失わないようにも配慮しています。
SheepGroom で対訳ファイルを作成するための手順は、こちらをご覧ください。
SheepBell
 LQA プロジェクトの経験から生まれたツールです。
私たちのチームでは LQA の際、OBS で録画しながらスクリーンショットを撮り、あとで報告書にまとめていました。
最初は問題ありません。しかし、4時間ほどレビューを続けていると、撮影したスクリーンショットがかなりの枚数になることがあります。 すると、
- 「これはどの場面だっただろう?」
- 「録画の何分何秒だっただろう?」 と探し直す時間が発生します。
そこで思いついたのが、「どうせヘッドセットを付けているのだから、気付いたことをその場で話し、その音声をマーカーとして使えばいいのでは?」という方法でした。
FFmpeg で自分のマイクトラックを切り出し、Audacity で波形を見て、声のあった分数を特定する…… この方法だけでも、手当たり次第に動画を見返すよりはずっと楽になりました。 ただ、動画の切り出しや画像の確認は別の作業として残ります。 そして思ったのです。
- これを一連の流れとして自動化できたら、LQA の振り返りがぐっと楽になるんじゃないか?
- 報告書自体も、動画のすぐ横で書きたい
そうして生まれたのが SheepBell です。
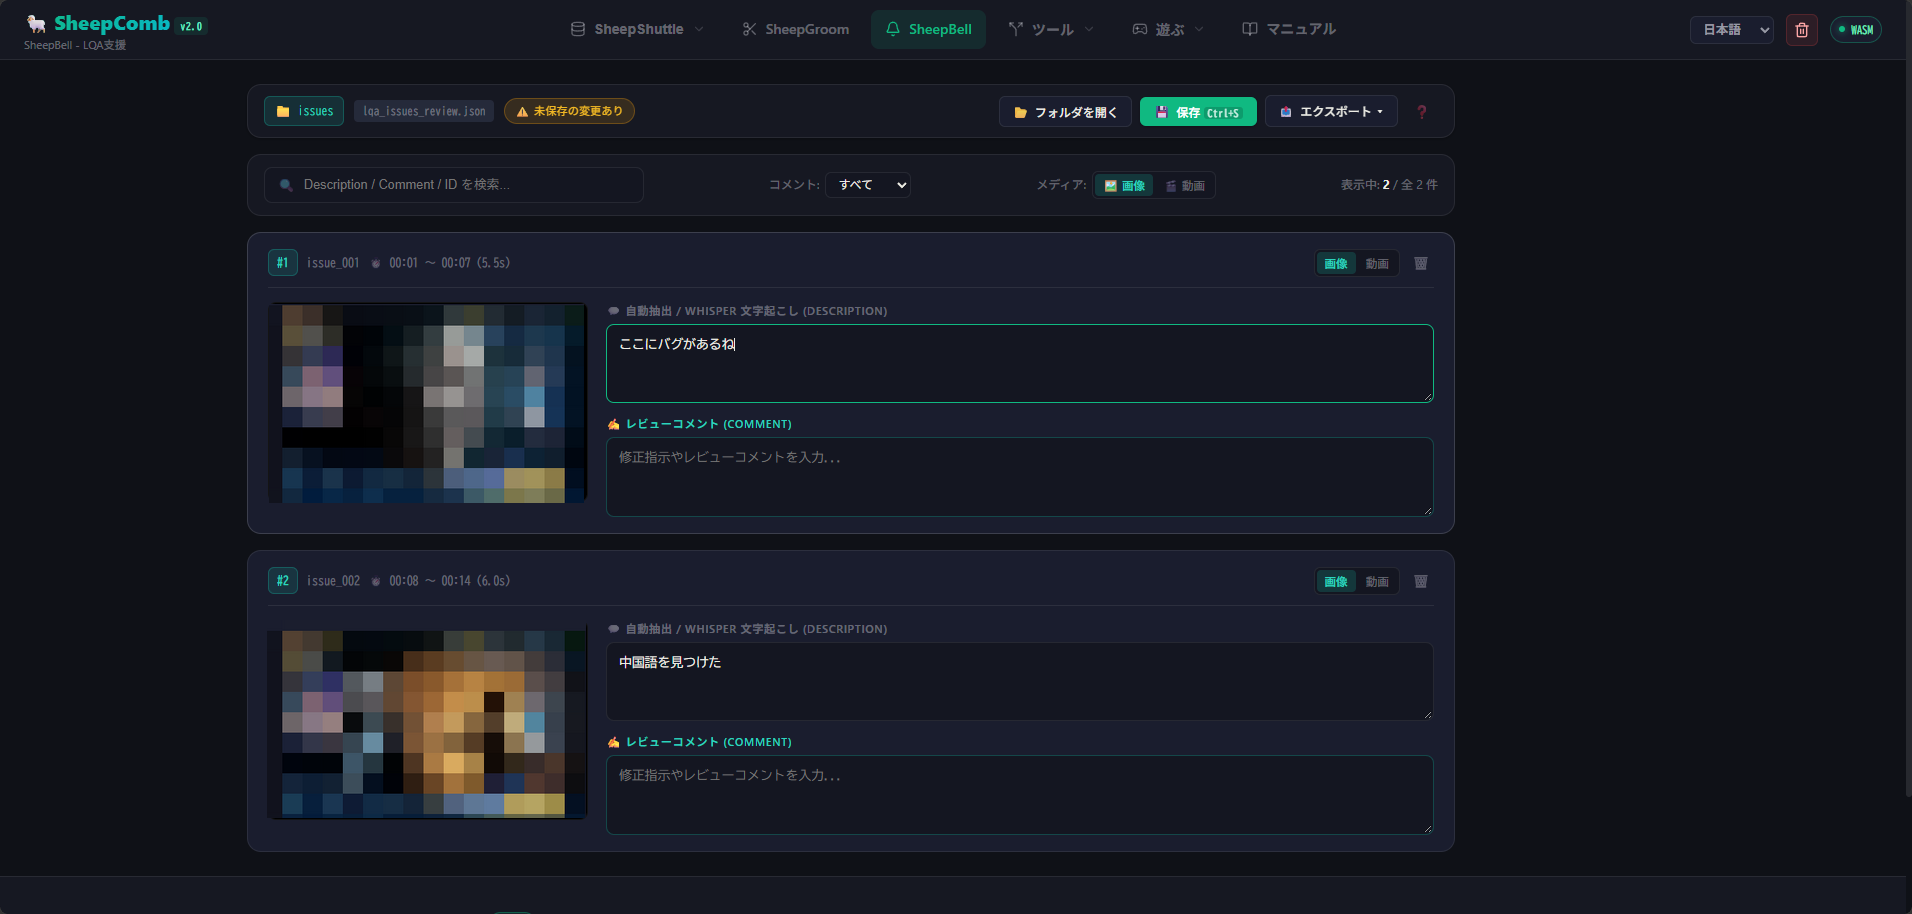
SheepBell は、音声のあった箇所を自動で検出し、動画クリップ・画像・文字起こしをまとめて管理することで、LQA の振り返りと報告作業を支援します。
SheepBell で LQA を行いたい場合は、こちらをご覧ください。
SheepComb の使い方
SheepComb はインストール不要で、お使いのブラウザ(Google Chrome 等)から直接ご利用いただけます。 SheepComb を開き、使いたい機能を選んでください。
なお、SheepBell の LQA 支援ツールは、フォルダアクセスの関係上、FireFox ではうまく動かないことがあります。